1. 背景与动机
当数据(图片、音频、文本)被 Embedding 模型向量化后,如何从海量向量中快速找到最近邻是一个核心问题(最近邻问题),这个过程称为最近邻搜索(Nearest Neighbor Search)。
精确最近邻(KNN)需要 O(N*d) 的暴力比较,数据量稍大就无法接受。近似最近邻搜索(ANN) 通过牺牲一点点精度换取数量级的加速,HNSW 是目前 ANN 领域的 SOTA 方案之一。
参考论文:Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs (Malkov & Yashunin, 2016)
2. 理论基础:六度分隔与可导航小世界
核心理论是六度人脉:世界上任意两人平均只需 6 个中间人就能建立联系。
2.1 可导航小世界公式
$$ \text{局部密友} + \text{少量远程捷径} = \text{任意两点之间距离极短} $$2.2 为什么需要远程捷径
纯局部连接形成的是网格/聚类——跨区域必须逐跳穿过中间节点,路径长度与节点数成正比(O(√N))。加入少量随机长边后,任意两点跳数降至 O(log N),这就是小世界图的核心性质。
3. 单层 NSW(Navigable Small World)
3.1 结构
- 稠密本地连接:每个向量只和离自己最近的 M 个向量建立连接(精确近邻边)
- 少量随机长边:插入过程中,新节点被随机连接到的早期节点会成为"枢纽",自动形成长边
3.2 搜索算法(贪心 KNN Search)
|
|
贪心搜索返回的是局部最优而非全局最优,但因为小世界图的拓扑性质,这个局部最优通常离全局最优很近。
3.3 优点与局限
优点:结构简单、高维友好、任意两点跳数少(5~6 跳)。
局限:
- 数据量百万级以上,跳数增长到 7~9 跳
- 没有全局入口策略——从任意点出发,第一次跳的目的地不可控
- 搜索路由可能先"绕远路"再收缩
4. 多层 HNSW(Hierarchical NSW)
4.1 设计思想
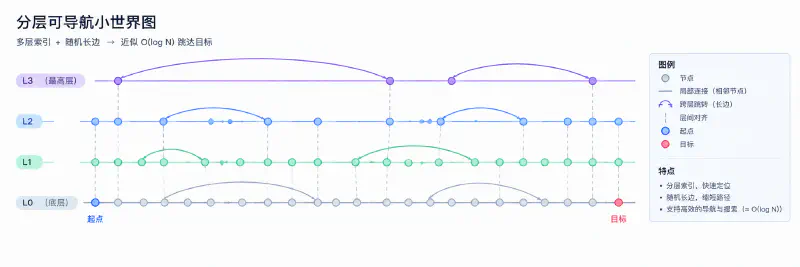
仿照社会分层:顶层是"跨领域大佬"(节点少、长边多),底层是"普通人"(全量节点、本地连接)。搜索时从顶层快速定位区域,逐层下沉精细搜索。
图层结构:
- Layer L(顶层):节点数最少,全是长边。类比社会名流
- Layer 1:节点指数级增多,长短边混合
- Layer 0(底层):全量节点 + 稠密近邻边,负责最终精准搜索

4.2 核心优势
从顶层一路贪心到底层,搜索路径从单层的 56 跳压缩到 **24 跳**。关键改进在于找到最好的起点——顶层节点天然就是优质入口。

5. 核心算法详解(以实现为导向)
5.1 层级分配 (Level Generation)
每个节点被分配一个随机层级 l,服从指数衰减分布:
|
|
性质:
- P(level ≥ k) ∝ exp(-k/mL),每上升一层节点数约除以 M
- 顶层期望节点数 = totalNodes × (1 - 1/M)^{topLayer}
- 例如 M=16, N=100万,顶层约 100万 × (1-1/16)^{3} ≈ 550 节点
5.2 SEARCH 算法
逐层贪心 + 底层扩大搜索(ef 参数控制宽度)。
|
|
为什么高层用 ef=1? 高层只为找到下一层入口点,不需要过多候选——选最好的一个就够了,减少无用计算。
5.3 INSERT 算法
插入 = 分配层级 + 逐层找邻居 + 双向连接 + 必要时剪枝。
|
|
5.4 SELECT-NEIGHBORS 邻居选择策略
这是 HNSW 的核心创新之一。两种策略:
Simple 策略(默认回退):
|
|
问题:选出来的邻居全挤在一起,缺乏"可导航性"。
Heuristic 策略(推荐):
|
|
其中 is_closer_to_existing 检查 dist(c, query) > dist(c, any_result),如果成立说明 c 被已有邻居"覆盖"了,不需要重复连接。
启发式选择的效果:生成的邻居在空间中分布更发散,远程捷径更丰富,搜索路径更短。
论文推荐:底层用 Mmax0 + heuristic,上层用 M + simple。这是因为底层需要高精度(heuristic 发散好),上层只需要快速路由(simple 足够且更快)。
5.5 连接剪枝 (Shrink Connections)
当一个节点的度数超过该层限制(M_max 或 M_max0)时,需要裁剪多余连接——同样用 heuristic 策略保留最"有价值"的邻居。
|
|
6. 参数体系深度解析
6.1 核心参数总表
| 参数 | 含义 | 典型范围 | 默认值(FAISS) | 对召回的影响 | 对延迟的影响 |
|---|---|---|---|---|---|
| M | 每层(非底层)最大连接数 | 12~48 | 32 | M ↑ → 图更密,召回↑ | M ↑ → 遍历任务↑,延迟↑ |
| M_max0 | 底层最大连接数 | 2M~4M | 64 | ↑ → 底层精度↑ | ↑ → 底层搜索慢 |
| ef_construction | 建图时搜索宽度 | 100~400 | 200 | ↑ → 图质量↑(边际递减) | ↑ → 建图慢(O(N log N) → O(N ef log)) |
| ef | 搜索时候选队列大小 | 10~500 | — | ↑ → 召回↑(调优最直接) | ↑ → 线性增加延迟 |
| mL | 层级衰减率 | 1/ln(M) ~ 1/log2(M) | 1/ln(M) | 大 → 上层节点多,路径长 | 太大 → 检索变慢;太小 → 顶层过快到底 |
6.2 M 与 M_max0 的关系
- M_max0 通常设为 2*M 或更大,因为底层承担最终精度
- 如果 M_max0 = M,底层节点的连接数容易被暴力剪掉太多,导致召回下降
- 实现中
limit(l)在l==0时返回M_max0,否则返回M
6.3 ef_construction 的选择
- ef_construction ∈ [M, 上限 ~2000]
- ef ∈ [1, 上限]
- 关系:ef_construction ≥ ef(否则建图搜索窄于检索,不合理)
- 典型搭配:ef_construction = 200(建图),ef 从 20 ~ 500(运行时动态调)
召回-ef 曲线有边际递减,建议画一次曲线找出拐点。
6.4 mL 的推导
$$ m_L = \frac{1}{\ln(M)} $$这个值保证每向上一层,期望节点数除以 M。推导:
在底层(level=0)有全部 N 个节点。一个节点出现在 level≥k 的概率是 $1/M^k$,所以 level≥k 的期望节点数是 $N / M^k$。当这个值小于 1 时,顶层建立:
$$ \frac{N}{M^{L}} < 1 \Rightarrow L > \log_M N = \frac{\ln N}{\ln M} $$所以顶层高度 ≈ $\ln N / \ln M$,M=32, N=100万 时顶层 ≈ 4 层。
6.5 参数交互关系
|
|
所以 M 和 mL 需要联动调,不能各自独立改。
7. 调参实战指南
7.1 精度优先场景(召回率 > 99%)
|
|
代价:建图慢(5~10 倍基准),内存大,检索延迟高。
7.2 延迟优先场景(高 QPS,~10ms 级)
|
|
代价:召回率可能降至 90~95%。
7.3 调参流程(推荐)
|
|
7.4 常见陷阱
| 现象 | 原因 | 解决 |
|---|---|---|
| 建图极慢 | ef_construction 太大 | 从 200 开始,上线前再加大 |
| 搜索慢但召回高 | 不需要那么高召回,ef 太大 | 减小 ef |
| 召回低但搜索快 | ef/M 太小 | 适当增加 ef / M |
| 建图后召回不随 ef 增长 | M_max0 太小,底层图太稀疏 | 增大 M_max0 |
| 内存 OOM | 参数过大 + 数据量超内存 | 减 M / 换 DiskANN / 分片 |
8. 工程实现注意事项
8.1 删除操作(HNSW 的软肋)
HNSW 原生不支持删除。删除一个节点意味着必须重建所有与被删节点相连的边——这在多层结构中极其复杂。
常见方案:
- 惰性标记(Tombstone):标记删除,搜索时跳过。简单,但被删节点仍占用内存,删除多了图质量下降
- 标记 + 周期性重建:累积到阈值(如 20%)后重建整个索引
- 原地替换:将删除节点的邻居重新连接(实现复杂,几乎不用)
实践中大部分生产系统(Milvus、FAISS)采用方案 1+2
8.2 更新操作
HNSW 不支持更新,通常实现为删除 + 重新插入。频繁更新的场景建议考虑其他索引(如 IVF 或磁盘方案)。
8.3 内存占用分析
每一层存储:
- 节点 ID(int):4B
- 邻居列表(边):每邻接 4B(指针)+ 距离值如果用预计算可额外存储
单节点内存 ≈ (M_max0 + M * avgLayers) * 4B + 固定开销
Estimate for N=100万, M=32:
- 底层连接数 ≈ N × M_max0 = 100万 × 64 = 6400万条边
- 上层连接数 ≈ N × (1 + 1/M + 1/M² + …) × M ≈ 100万 × 1.03 × 32 ≈ 3300万条边
- 总边数 ≈ 1亿条边 ≈ 400MB~800MB(看指针/距离存储方式)
实际中 HNSW 内存占用约为原始数据的 2~5 倍(取决于 M 和 M_max0)。M=32 时,100万 128维 float 数据约占用 1~2GB。
8.4 并发安全
- 搜索(读取):天然支持无锁并发——搜索只读,不修改图
- 插入(写入):需要加锁。常见做法:
- 全局读写锁(简单但写入时阻塞搜索)
- 逐层锁 + CAS(复杂,高性能)
- 批量插入后重建(离线场景)
8.5 内存随数据增长的分析
HNSW 是纯内存索引,数据规模超过可用内存时无法工作。大规模(亿级以上)的选择:
- DiskANN:HNSW 思想的磁盘版,用 SSD 分页存储图,只加载热数据到内存
- 分布式 HNSW:按 ID 范围分片,每台机器一个独立图,用 Router 合并结果(Milvus 方案)
- 混合:Product Quantization (PQ):压缩向量后用 HNSW,适合显存不足的 GPU 场景
9. HNSW vs 其他 ANN 算法
| 算法 | 检索延迟 | 建图速度 | 内存占用 | 高维支持 | 更新友好 | 适用场景 |
|---|---|---|---|---|---|---|
| HNSW | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐(大) | ⭐⭐⭐⭐⭐ | ❌ | 小~中规模、高精度、纯内存 |
| IVF | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ✅ | 大数据量、GPU加速 |
| IVF+HNSW | ⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ✅ | 兼顾精度与规模(Milvus 默认) |
| KD-Tree | ⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐(d<20) | ❌ | 低维空间、精确搜索 |
| LSH | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐ | ✅ | 理论保证、特定距离函数 |
| DiskANN | ⭐⭐⭐⭐ | ⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ✅ | 超大规模(亿级+)、SSD部署 |
为什么 HNSW 仍然是"最好"的?
- 召回-延迟 Pareto 前沿最先进——同等召回率下延迟最低,同等延迟下召回最高
- 一个索引搞定,不需要训练(IVF 需要训练聚类)——部署简单
- FAISS、Milvus、Qdrant、Weaviate、Chroma、Elasticsearch 都在用
什么时候不用 HNSW?
- 数据规模超大且内存不足 → DiskANN / 分片
- 需要频繁增删改 → IVF / DiskANN
- 需要确定性精确结果 → KD-Tree / Brute Force
- 部署在 GPU 上 → GPU-IVF(HNSW 不擅长 GPU 并行化)
10. 从理论到实现的路线图
如果自己实现 HNSW,推荐步骤:
|
|
开源参考实现:
- FAISS(CPU): https://github.com/facebookresearch/faiss/blob/main/faiss/impl/HNSW.cpp
- HNSWlib: https://github.com/nmslib/hnswlib(最干净的原版实现,建议从这读起)
- nmslib: https://github.com/nmslib/nmslib