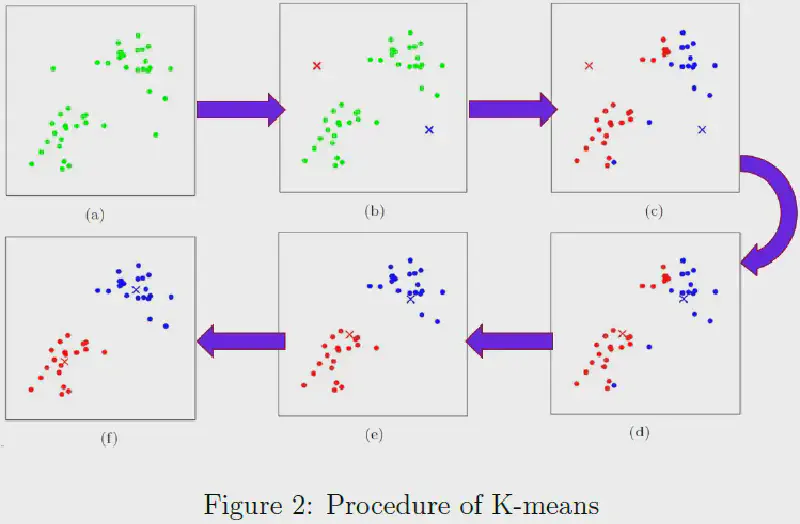
一、算法概述
K-Means(K 均值聚类)是一种基于划分的无监督学习算法,用于把 $n$ 个样本划分为 $K$ 个簇(cluster),使得簇内的样本尽可能相似(紧凑),簇间的样本尽可能不同(分离)。
其核心思想可以概括为:
不断迭代"分配—更新"两步:把样本分给最近的簇中心,再重新计算簇中心,直到簇中心不再变化。
二、数学形式化
2.1 问题定义
设样本集为 $X = {x_1, x_2, \cdots, x_n}$,其中每个样本 $x_i \in \mathbb{R}^d$ 是一个 $d$ 维向量。目标是找到 $K$ 个簇中心 $\mu_1, \mu_2, \cdots, \mu_K$,以及每个样本的簇归属 ${c_i \in {1, 2, \cdots, K}}$,使得损失函数(目标函数)最小化。
2.2 目标函数
K-Means 最小化的是簇内误差平方和(Sum of Squared Errors, SSE),也称作惯性(Inertia):
$$ J = \sum_{i=1}^{n} \sum_{k=1}^{K} w_{ik} \cdot \|x_i - \mu_k\|_2^2 $$其中:
- $|\cdot|_2$ 表示 L2 范数(欧氏距离);
- $w_{ik} \in {0, 1}$ 是指示变量:当样本 $x_i$ 属于簇 $k$ 时 $w_{ik} = 1$,否则为 $0$;
- $\mu_k$ 是簇 $k$ 的中心(质心)。
展开欧氏距离,目标函数可写为:
$$ J = \sum_{i=1}^{n} \sum_{k=1}^{K} w_{ik} \sum_{j=1}^{d} (x_{ij} - \mu_{kj})^2 $$2.3 最优解推导
该目标函数是非凸的(关于 $w_{ik}$ 和 $\mu_k$ 是联合非凸的),因此无法直接求全局最优解。K-Means 采用**坐标下降(Coordinate Descent)**策略,交替固定一个变量、优化另一个变量。
(1)固定簇中心 $\mu_k$,优化归属 $w_{ik}$(分配步)
每个样本 $x_i$ 应归属于离它最近的簇中心:
$$ w_{ik} = \begin{cases} 1 & \text{if } k = \arg\min_k \|x_i - \mu_k\|_2^2 \\ 0 & \text{otherwise} \end{cases} $$(2)固定归属 $w_{ik}$,优化簇中心 $\mu_k$(更新步)
对 $\mu_k$ 求偏导并令其为 $0$:
$$ \frac{\partial J}{\partial \mu_k} = -2 \sum_{i=1}^{n} w_{ik} (x_i - \mu_k) = 0 $$解得簇中心为簇内所有样本的均值(mean):
$$ \mu_k = \frac{\sum_{i=1}^{n} w_{ik} x_i}{\sum_{i=1}^{n} w_{ik}} = \frac{1}{|C_k|} \sum_{x_i \in C_k} x_i $$其中 $C_k = {x_i \mid w_{ik} = 1}$ 表示簇 $k$ 中的样本集合,$|C_k|$ 为该簇的样本个数。这正是"K-Means(均值)“名称的由来。
2.4 收敛性
- 每次分配步会不增加目标函数 $J$(每个样本都被分配到了最近的中心);
- 每次更新步取均值是当前归属下的最优解,同样不增加 $J$;
- $J$ 有下界($\geq 0$),且有限的分配方案只有有限种,因此算法必然收敛。
但注意:收敛只能保证到达局部最优(局部极小值),无法保证全局最优,最终结果高度依赖于初始簇中心的选择。
三、伪代码
3.1 标准 K-Means(Lloyd 算法)
|
|
3.2 时间复杂度
- 每轮迭代:计算所有 $n$ 个样本到 $K$ 个中心的距离,共 $O(n \cdot K \cdot d)$;
- 总复杂度:$O(n \cdot K \cdot d \cdot T)$,其中 $T$ 为迭代轮数(通常 $T$ 很小,收敛很快)。
四、初始化方法(K-Means++)
标准随机初始化容易陷入差的局部最优。K-Means++ 通过让初始中心彼此尽量远离来改善结果:
|
|
五、K 值的选择
K-Means 需要预先指定 K,常用的选择方法:
- 肘部法(Elbow Method):绘制不同 K 下的 SSE 曲线,选择"肘部"拐点处的 K;
- 轮廓系数(Silhouette Coefficient):综合衡量簇内紧凑度与簇间分离度,选择使平均轮廓系数最大的 K;
- Gap Statistic:将 SSE 与随机参考分布的 SSE 对比,选取差距最大的 K。
六、优缺点与注意事项
优点:
- 简单、高效,时间复杂度低,适合大规模数据;
- 思想直观,易于实现与解释。
缺点:
- 需预先指定 K;
- 对初始中心敏感,可能陷入局部最优;
- 对异常值(outliers)敏感(均值会被拉偏);
- 只适用于凸形、等大小的簇,对任意形状的簇效果差;
- 对特征尺度敏感,使用前通常需要标准化(z-score / Min-Max);
- 本质是硬划分(hard assignment),每个样本只能属于一个簇。